AI-системи вже постійно читають сайти: щоб відповідати користувачам і виконувати завдання як AI-агенти. Для їхньої зручності запропонували файл llms.txt — коротку карту ключового контенту сайту. Довкола нього виникло чимало міфів: його називають новим SEO-фактором або обов’язковою умовою для появи в ChatGPT чи Google AI Overviews.
У цій статті розберемо:
llms.txt — це запропонована специфікація Markdown-файлу, який розміщують на сайті. Він містить короткий опис проєкту, важливий контекст і посилання на ключові матеріали.
Пропозицію створив Jeremy Howard у вересні 2024 року. Поточна версія специфікації — v2, оновлена 10 серпня 2026 року. Важливо: це саме пропозиція щодо стандартизації, а не обов’язковий вебстандарт.
Якщо спростити, llms.txt — це короткий навігатор для AI-агента:
ось що це за сайт, які матеріали на ньому найважливіші та де знайти детальну інформацію.
Файл не мусить містити всю інформацію сайту. Навпаки, його завдання — дати стислий контекст і посилання на матеріали, які агент завантажить за потреби.
Звичайні HTML-сторінки створені для людей і перевантажені навігацією, кодом та рекламою. llms.txt дає AI-агенту компактну точку входу: короткий опис сайту та структурований список важливих ресурсів. Деталі агент завантажує за посиланнями лише тоді, коли це справді потрібно.
Проте це не гарантія: наявність файлу не означає, що кожен AI-сервіс його прочитає чи використає.
Обов’язковий лише один елемент — заголовок H1 із назвою сайту чи проєкту. Решта елементів рекомендовані й ідуть у такому порядку:
- [Назва](URL): короткий опис ресурсу.Найпоширеніший варіант — у корені домену:
https://example.com/llms.txt
Але специфікація v2 дозволяє розміщувати файл і в окремому підрозділі сайту:
https://example.com/docs/llms.txt
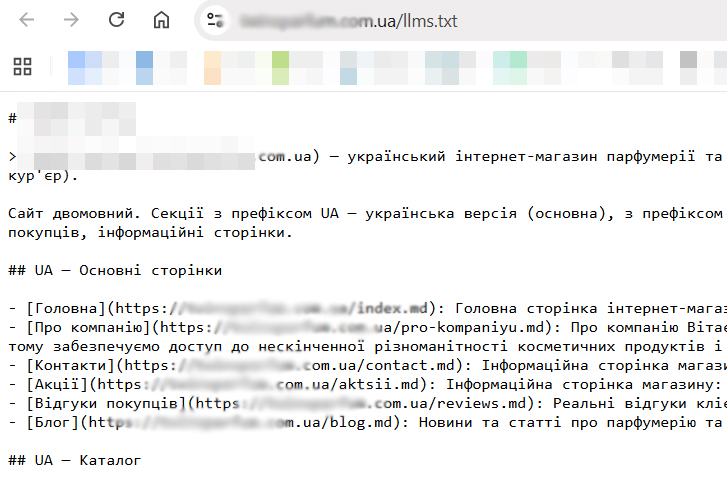
У такому випадку файл описує URL у межах свого шляху. Якщо до одного URL підходить кілька файлів, агент має використовувати найспецифічніший. Це особливо зручно для великих сайтів із незалежними розділами: документацією, базою знань, окремим продуктом.
llms.txt задуманий передусім для сценаріїв inference — коли AI-агенту під час виконання запиту потрібно зорієнтуватися на сайті й знайти релевантні матеріали. Він слугує навігатором, а не заміною robots.txt для керування доступом краулерів.
Формат залишається запропонованою ініціативою, а не обов’язковим стандартом. Жоден із великих AI-сервісів не підтвердив, що читає llms.txt під час відповідей користувачам.
Дослідження Ahrefs (червень 2026 року) охопило 137 210 доменів: llms.txt мали 28% із них. Серед приблизно 38 тис. сайтів із файлом 97% не отримали жодного запиту до нього за травень 2026 року. 96% запитів, які все ж надходили, робили боти. При цьому 77% цих ботів узагалі не належали AI-сервісам — це SEO-аудитори, сканери технологій та інші краулери. На AI retrieval bots, які шукають матеріали для відповідей в AI-пошуку (OAI-SearchBot, PerplexityBot), припало лише 1,1% запитів від ботів.
Дослідження не доводить, що файл ніколи не використовується, але показує: поки що його читають далеко не всі.
Отже, llms.txt — опціональний навігаційний формат для сумісних агентів, а не гарантований канал зв’язку з усіма AI-системами.
Ці три файли вирішують різні завдання.
| Файл | Основне завдання |
| robots.txt | Вказує автоматизованим системам правила доступу до частин сайту |
| sitemap.xml | Допомагає пошуковим системам знаходити URL сайту |
| llms.txt | Дає AI-агентам стислий контекст і добірку важливих матеріалів |
Чи замінює llms.txt інші технічні файли? Ні. llms.txt не встановлює правил доступу і не замінює інші файли:
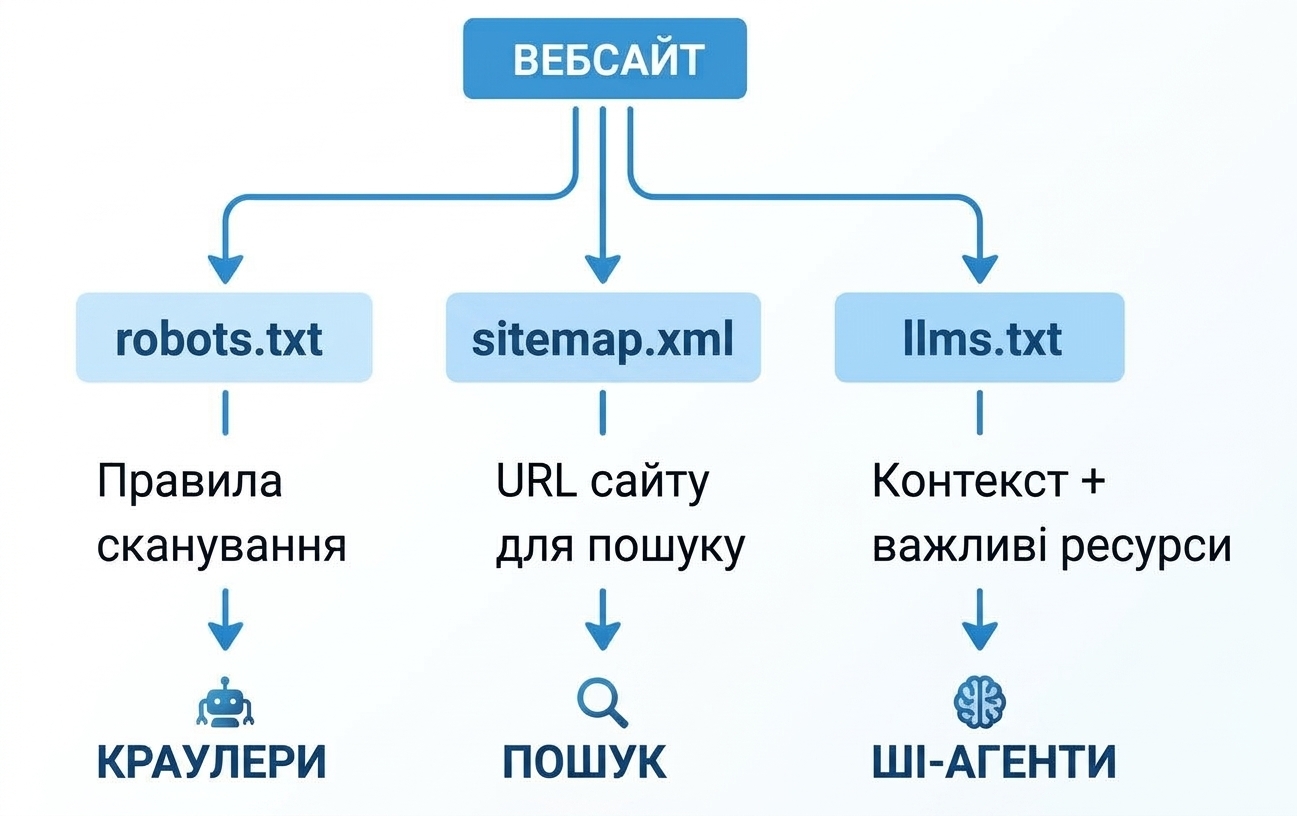
Зазвичай усі три файли лежать у корені сайту: /robots.txt, /sitemap.xml, /llms.txt. Але це не обов’язково: карта сайту може мати іншу адресу (її вказують у robots.txt), а llms.txt — лежати в підрозділі.
llms.txt не є фактором ранжування. Google прямо зазначає, що такі файли не потрібні для появи в Google Search, зокрема в його генеративних функціях: Google Search їх ігнорує. Тому llms.txt не покращує і не погіршує видимість чи позиції сайту в Google.
Саме по собі створення файлу:
Файл найкорисніший для проєктів із великим обсягом структурованої та технічної інформації:
Для невеликого сайту з кількома сторінками практична користь від окремого навігаційного файлу невелика. Створювати llms.txt лише заради SEO не має сенсу, бо Google не сприймає його як сигнал для ранжування.
Створення файлу не потребує складної розмітки. Головне — вибрати справді важливі матеріали й подати їх компактно.
До файлу можна включити:
Не потрібно додавати кожен URL сайту.
Базовий файл може виглядати так:
# Назва сайту
> Короткий опис компанії, продукту або проєкту та контекст, необхідний для розуміння наведених матеріалів.
## Документація
- [Початок роботи](https://example.com/docs/start): інструкція для нових користувачів.
- [API Reference](https://example.com/docs/api): повний опис API та параметрів.
## Продукти
- [Продукт 1](https://example.com/product-1): опис можливостей і сценаріїв використання.
- [Продукт 2](https://example.com/product-2): функції, обмеження та умови використання.
## Гайди
- [Посібник з налаштування](https://example.com/guide): покрокова інструкція.
За специфікацією обов’язковий лише H1. Blockquote і секції з посиланнями — рекомендовані елементи структури.
Краще не залишати список URL без контексту. Порівняйте:
- [Документація](https://example.com/docs)
і:
- [Документація](https://example.com/docs): повний опис налаштування, API та основних сценаріїв використання.
Другий варіант дає агенту більше інформації про те, що саме він знайде за посиланням.
Файл має бути компактним покажчиком, а не великою статтею. Детальні пояснення, характеристики продуктів, інструкції та інші матеріали краще залишати на окремих сторінках, на які посилається llms.txt.
Специфікація v2 пропонує не обмежуватися самим llms.txt, а давати AI-агентам чисті Markdown-версії сторінок — за тією ж адресою з розширенням .md. Наприклад, для сторінки:
https://example.com/docs/api.html
Markdown-версія може бути за адресою:
https://example.com/docs/api.html.md або https://example.com/docs/api.md
Щоб агенти знаходили такі версії, специфікація рекомендує стандартні зв’язки:
<link rel="alternate" type="text/markdown" href="/docs/api.md">
<link rel="describedby" href="/docs/llms.txt">
Перший вказує на Markdown-версію сторінки, другий — на llms.txt, який її описує. Ці зв’язки можна передавати як HTML-теги <link> або як HTTP-заголовок Link — це зручно, якщо не хочеться змінювати шаблони сторінок.
Для всього сайту:
https://example.com/llms.txt
Для окремого розділу:
https://example.com/docs/llms.txt
Після публікації перевірте, що файл відкривається без авторизації, повертає код відповіді 200, а всі посилання всередині нього працюють.
Якщо змінюються продукти, документація, URL або структура сайту, ці зміни потрібно внести й до llms.txt. Застарілий список посилань менш корисний, ніж актуальний компактний покажчик.
У WordPress llms.txt можна створити вручну й завантажити в корінь сайту або згенерувати плагіном: генератор файлу є, наприклад, у Yoast SEO та AIOSEO. Wix створює llms.txt автоматично для кожного сайту, а платформи документації — для опублікованої документації.
Після автоматичного створення обов’язково перевірте результат. Генератори часто додають у файл усі сторінки, записи й категорії підряд — а це саме та помилка, від якої застерігає специфікація. Приберіть службові та другорядні URL і залиште ключові. Для невеликих сайтів ручного створення файлу зазвичай достатньо.
Для умовного SaaS-сервісу файл може мати такий вигляд:
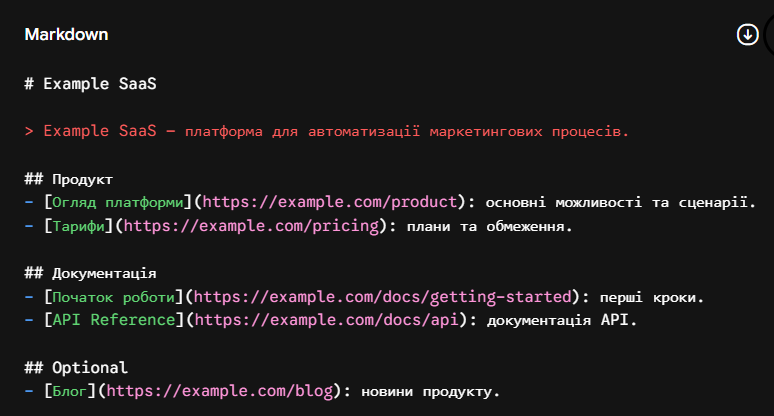
Секція Optional тут містить другорядний контент. Це конвенція специфікації, а не команда, яка змушує AI-систему певним чином обробляти файл.
llms-full.txt часто згадують разом із llms.txt, але це різні речі.
Специфікація llms.txt не описує llms-full.txt. Цей формат використовують окремі платформи документації: вони збирають у такий файл повний текст документації одним документом.
Тому наявність llms-full.txt на конкретному сайті — рішення цієї платформи, а не вимога для всіх вебсайтів.
llms.txt не повинен перетворюватися на другу sitemap.xml. Краще вибрати матеріали, які справді допомагають зрозуміти продукт, послуги або тематику сайту.
Мета файлу — не перелічити всі сторінки, а дати структурований і відібраний контекст.
llms.txt не керує доступом краулерів. Для правил сканування використовують robots.txt.
Якщо URL змінився, його потрібно оновити і в llms.txt. Періодична перевірка посилань — частина нормального обслуговування файлу.
Наявність llms.txt не гарантує, що AI-система процитує сайт, згадає бренд або приведе додатковий трафік. Для Google Search це підтверджено прямо: Google Search ігнорує llms.txt.
GEO (Generative Engine Optimization) — підходи до оптимізації видимості контенту в генеративних пошукових та AI-системах. Чим GEO відрізняється від класичного SEO, ми розбирали окремо. llms.txt можна розглядати як один із додаткових технічних елементів такої роботи, але він не замінює фундаментальне SEO, якісний контент і технічну доступність сайту. Google для генеративних функцій Search радить і далі застосовувати базові SEO-практики, а не шукати окремі «AI-хаки».
| llms.txt робить | llms.txt не робить |
| Дає короткий контекст | Не керує скануванням |
| Посилається на важливі матеріали | Не замінює sitemap.xml |
| Допомагає структурувати контент для сумісних агентів | Не є фактором ранжування в Google |
| Може спростити навігацію AI-агента | Не гарантує цитування |
| Може містити посилання на Markdown-версії | Не гарантує появу в ChatGPT |
Файл можна порівняти зі змістом книги: він допомагає зрозуміти структуру, але не замінює сам матеріал. Якщо на сайті немає якісної документації, корисних сторінок або актуальної інформації, список посилань сам по собі не зробить контент ціннішим для користувачів чи AI-систем.
Для сайту, який хоче бути помітним у пошуку та AI-сервісах, базовими залишаються:
llms.txt може доповнювати цю систему, але сам по собі не визначає, чи процитує сторінку або згадає бренд конкретна AI-система. Що реально впливає на появу у відповідях ChatGPT, Perplexity та інших AI-систем, ми розповідали в окремій статті.
llms.txt — опціональна специфікація для швидкої навігації AI-агентів по важливому контенту сайту. Найкорисніша вона для проєктів із великим обсягом технічної документації, баз знань і SaaS-рішень.
Водночас файл не є обов’язковим елементом SEO і не гарантує появи бренду у відповідях ChatGPT, Perplexity чи Google AI Overviews. Google прямо зазначає, що llms.txt не впливає на ранжування або видимість у пошуку.
Якщо створення та підтримка файлу не потребують значних ресурсів, його можна додати як елемент AI-friendly архітектури. Проте основний фокус варто тримати на якісному контенті, фундаментальному SEO та технічній доступності сайту — саме з цим ми працюємо в межах послуги GEO-просування.