A/B-тестування покликане замінити здогадки підтвердженими даними. Проте між статистично значущим результатом у звіті та реальним бізнес-ефектом може бути суттєва різниця. Зростання конверсії може виявитися випадковим коливанням, наслідком некоректного розподілу трафіку або ефектом, який супроводжується падінням середнього чека.
Ціна таких помилок може бути високою: команда витрачає ресурси на непотрібні зміни, маркетинг отримує хибні орієнтири, а бізнес — неочікуваний фінансовий результат. Проблема виникає тоді, коли A/B-тест сприймають як просте порівняння двох показників конверсії, ігноруючи методологію експерименту.
Надійний експеримент потребує чіткої гіпотези, правильно розрахованої вибірки та заздалегідь визначених правил проведення й інтерпретації. У цій статті розберемо головні статистичні та організаційні пастки A/B-тестування та з’ясуємо, як перетворити результати експерименту на обґрунтовані бізнес-рішення.
Надійність A/B-тесту значною мірою визначається ще до його запуску. Якщо заздалегідь не визначити гіпотезу, ключові метрики та правила проведення експерименту, отримані дані легко інтерпретувати неправильно.
Підхід «давайте щось змінимо й подивимося, що буде» створює ризик отримати результат, який складно пояснити. До початку тесту варто сформулювати перевірювану гіпотезу за простою схемою:
Якщо ми змінимо X, це вплине на Y, тому що Z.
Наприклад: якщо скоротити форму замовлення з 6 полів до 3, конверсія зросте, тому що користувачам буде простіше її заповнити.
Також заздалегідь слід визначити, який результат матиме практичну цінність для бізнесу і який мінімальний ефект має сенс виявляти.
Однієї конверсії часто недостатньо для оцінки експерименту.
Наприклад, нова сторінка може збільшити кількість замовлень, але водночас зменшити середній чек. Якщо дивитися лише на конверсію, такий результат легко інтерпретувати неправильно. Тому ключові метрики краще визначити до запуску тесту, а не вибирати після перегляду результатів.
Не варто зупиняти тест за принципом «зібрали 100 конверсій — достатньо». Необхідний розмір вибірки залежить від поточної конверсії, очікуваного ефекту, допустимого рівня статистичної помилки та бажаної статистичної потужності.
Тут важливий показник MDE (Minimum Detectable Effect) — мінімальний ефект, який тест має бути здатний виявити. Його варто пов’язувати не лише зі статистикою, а й із бізнес-цінністю зміни: якщо дуже невелике зростання метрики не має практичного значення, немає сенсу будувати експеримент навколо такого ефекту.
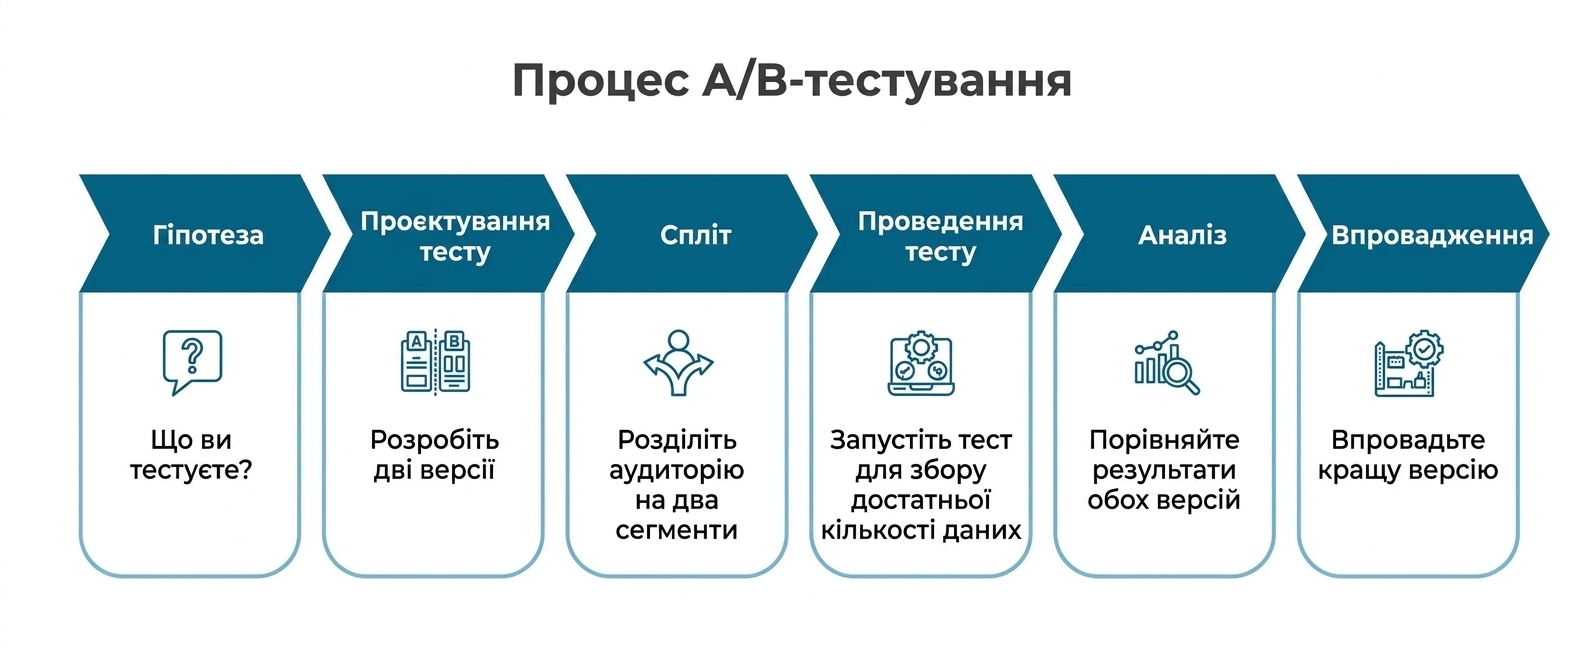
Отже, ще до старту потрібно визначити гіпотезу, основну метрику, мінімально практично важливий ефект і необхідний обсяг даних. Це створює чіткі правила експерименту та зменшує ризик підлаштовувати їх під отриманий результат.
Навіть добре спланований A/B-тест можна зіпсувати вже під час збору даних. Найчастіші проблеми — передчасна зупинка, зовнішні фактори, некоректний розподіл користувачів і пошук позитивного результату серед великої кількості порівнянь.
Якщо перевіряти результати щодня і зупинити тест одразу після появи статистично значущої різниці, можна прийняти випадкове коливання за реальний ефект. Чим більше разів перевіряти дані без урахування цього в статистичному плані, тим вищий ризик хибнопозитивного висновку.
Тому до запуску потрібно визначити розмір вибірки та критерії завершення тесту. Не варто зупиняти експеримент лише тому, що сьогодні p-value стало меншим за 0,05.
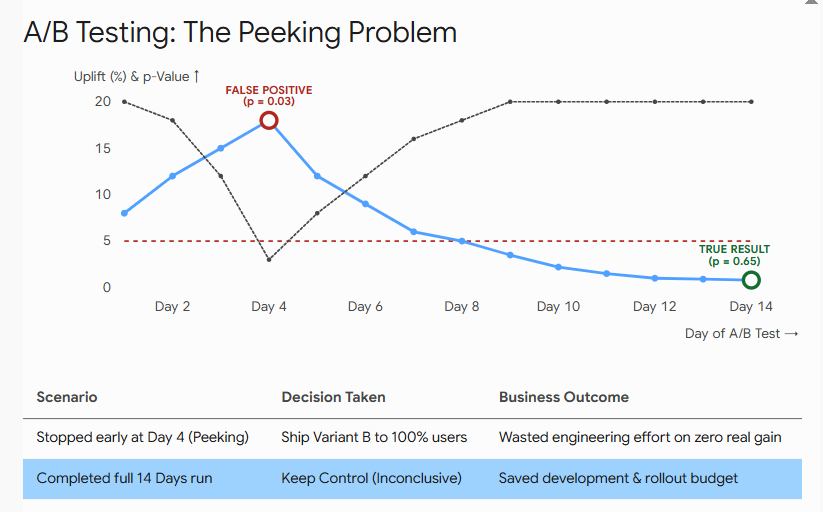
Порівняльний блок показує бізнес-наслідки обох рішень:
Результат у середині тесту не обов’язково є фінальним результатом.
Якщо бізнесу потрібно регулярно приймати рішення ще до завершення запланованого тесту, можна використовувати спеціальні методи послідовного аналізу (Sequential Testing), які враховують багаторазові перевірки даних.
На результати A/B-тесту можуть впливати не лише зміни між варіантами, а й події навколо експерименту: рекламні кампанії, розпродажі, свята, технічні збої або зміни джерел трафіку.
Наприклад, під час великої акції на сайт може прийти нетипова аудиторія, а збій платіжної системи — одночасно знизити конверсію в обох групах.
Тому тривалість тесту потрібно визначати не за універсальним правилом «7 чи 14 днів», а з урахуванням необхідного обсягу вибірки, сезонності та бізнес-циклів. Якщо поведінка користувачів сильно відрізняється протягом тижня, варто охопити повні цикли, а не завершувати тест посеред них.
Для коректного A/B-тесту користувачі мають випадково розподілятися між групами та, як правило, залишатися в одній групі протягом експерименту.
Перед запуском складніших тестів може бути корисним A/A-тест — коли обидві групи отримують однаковий варіант. Він допомагає перевірити механіку рандомізації, трекінг і можливі систематичні проблеми.
Окремо варто стежити за Sample Ratio Mismatch (SRM) — ситуацією, коли фактичний розподіл користувачів суттєво відрізняється від запланованого. Наприклад, замість очікуваних 50/50 система стабільно розподіляє трафік 52/48.
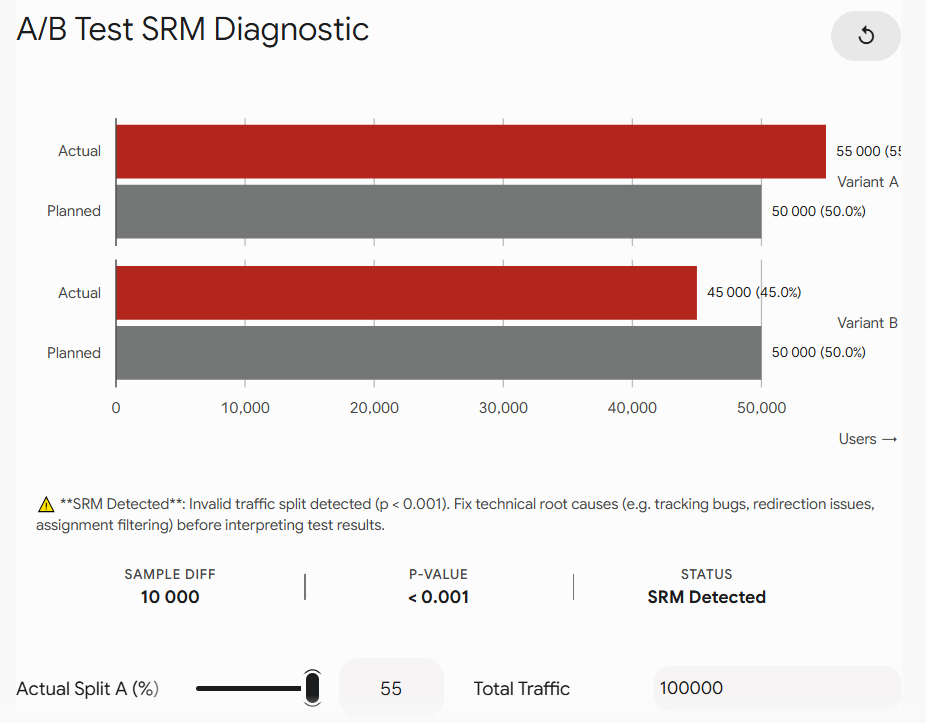
SRM може бути сигналом технічної проблеми, помилки в логіці експерименту або особливостей збору даних. Поки причина не з’ясована, результати такого тесту потрібно інтерпретувати дуже обережно.
Ще одна пастка — одночасно тестувати багато варіантів або після завершення експерименту перевіряти десятки сегментів у пошуках позитивного результату.
Чим більше незалежних порівнянь ми робимо, тим вища ймовірність випадково отримати статистично значущий результат. Наприклад, якщо перевіряти багато сегментів, можна знайти групу, де B показав позитивний результат просто через статистичний шум.
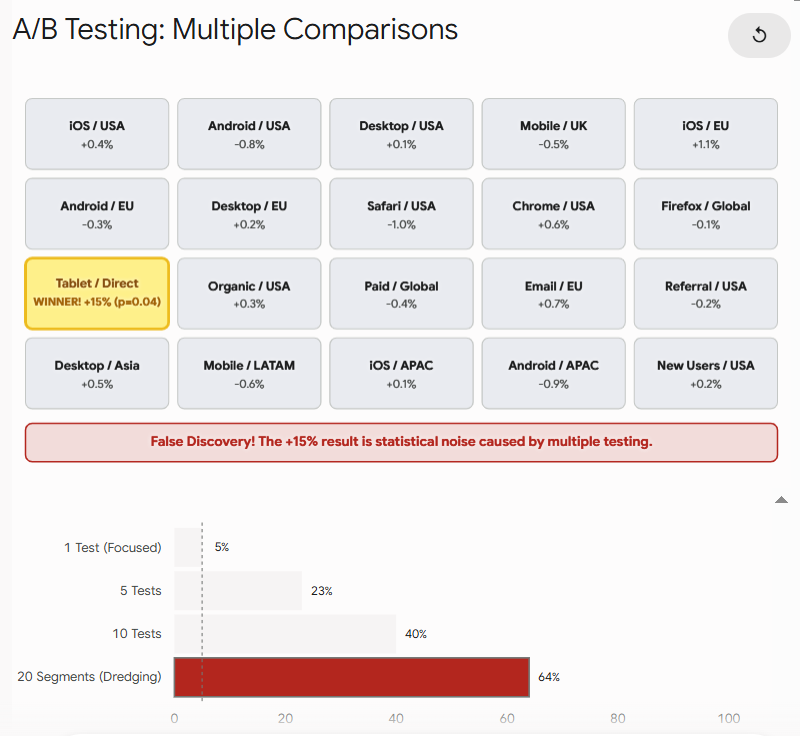
Тому важливі порівняння та сегменти краще визначати до початку тесту. Якщо ж одночасно перевіряється багато гіпотез, можуть знадобитися методи корекції множинних порівнянь, зокрема Bonferroni або контроль FDR.
Завершення тесту та статистично значущий результат ще не означають, що зміну потрібно одразу впроваджувати. Після завершення експерименту важливо оцінити не лише статистичний результат, а й розмір ефекту, його бізнес-цінність та умови, за яких він був отриманий.
p < 0,05 означає, що за заданої статистичної моделі отримані дані були б малоймовірними за припущення про відсутність ефекту. Але цей показник сам по собі не показує ані розмір ефекту, ані його економічну цінність.
На великій вибірці статистично значущим може стати навіть дуже невелике зростання конверсії. Тому після тесту варто оцінити:
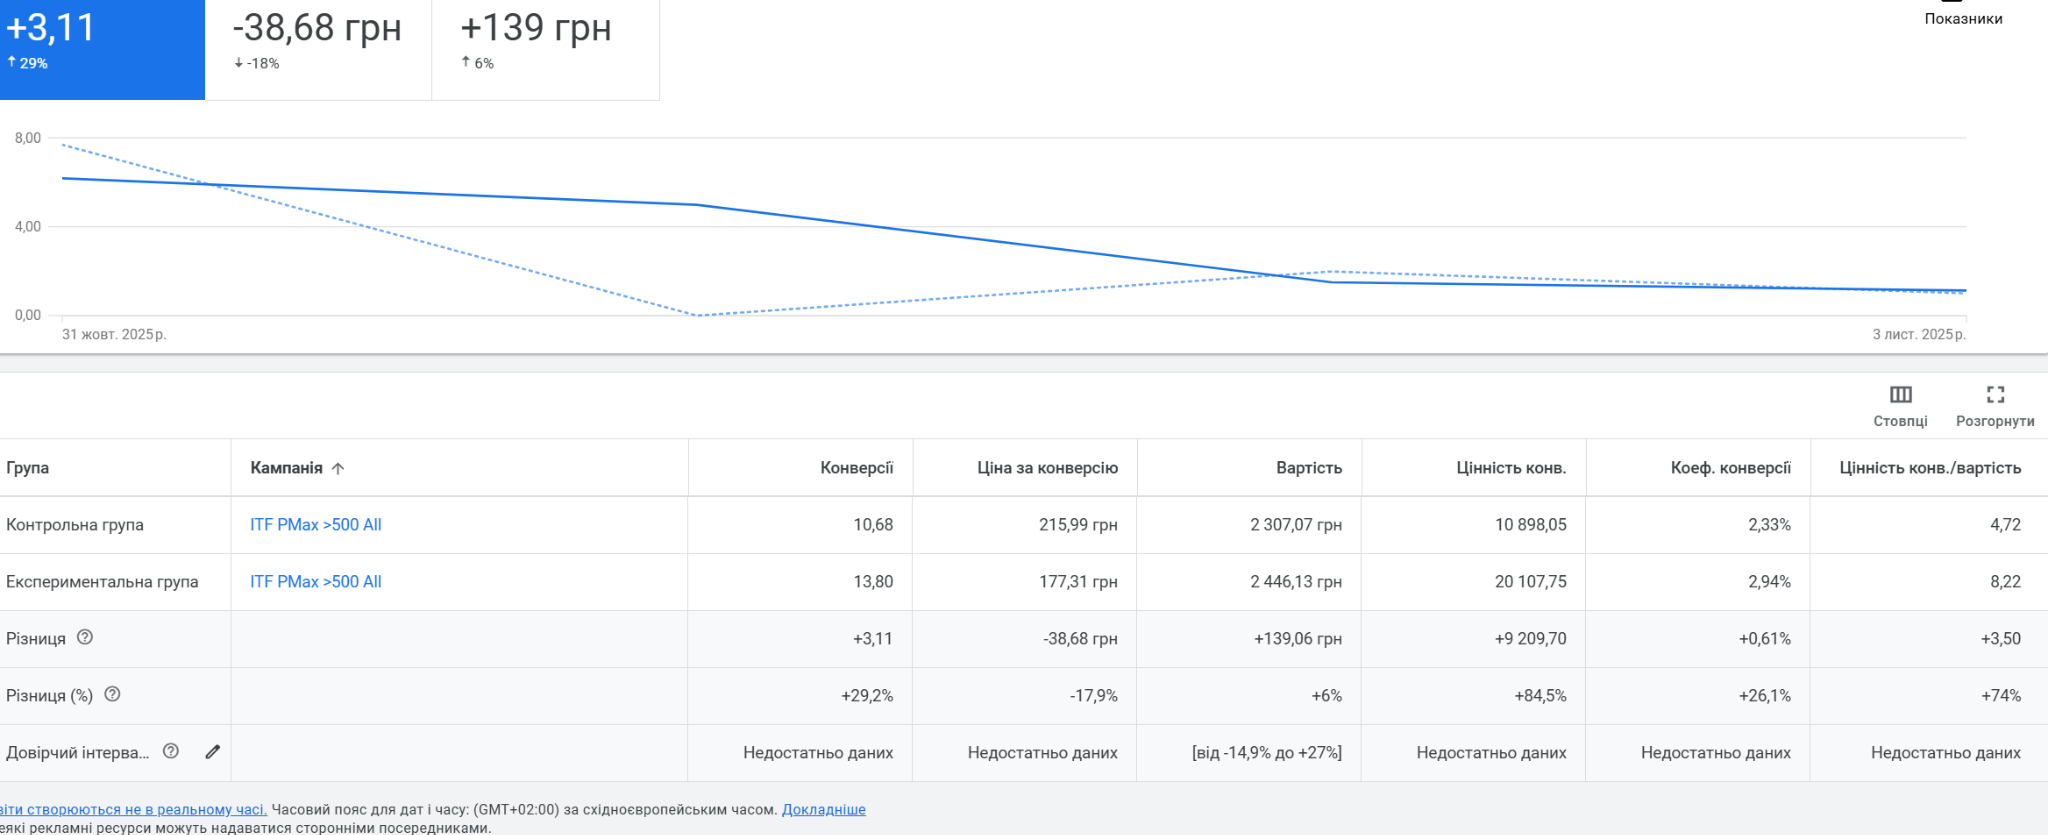
Скріншот з Google Ads Experiments: ілюзія швидкої перемоги. Попри вражаюче зростання показників (ROAS +74%), алгоритм застерігає — «Недостатньо даних». Якщо зупинити тест на цьому етапі, висновки будуть статистично недостовірними.
MDE визначають до запуску тесту як мінімальний ефект, який має практичне значення для бізнесу. Якщо статистично значущий результат виявився набагато меншим за цей орієнтир, це привід оцінити доцільність зміни, а не просто оголошувати B переможцем.
A/B-тест із правильною рандомізацією дає підстави робити причинний висновок: за умов проведеного експерименту зміна X спричинила зміну Y.
Але такий результат не обов’язково буде однаковим для будь-якої аудиторії та в будь-який момент. Ефект може відрізнятися залежно від:
Тому висновок краще формулювати конкретно: «У проведеному експерименті зміна X збільшила Y», а не «ця зміна завжди збільшує Y».
Після тесту легко знайти позитивний результат у якомусь сегменті, якщо перевірити достатньо багато варіантів: пристрої, країни, джерела трафіку тощо.
Якщо сегмент був визначений до запуску тесту і для нього існувала окрема гіпотеза, його аналіз має чітке обґрунтування. Якщо ж після загального результату перевірити десятки сегментів і вибрати той, де випадково вийшов +15%, це може бути наслідком множинного тестування. Тому несподівані сегментні знахідки краще розглядати як нові гіпотези для перевірки, а не як готовий доказ для впровадження.
Так само варто перевіряти структуру трафіку: якщо частки різних типів користувачів у групах A і B помітно відрізняються, це може впливати на загальний результат і потребує окремої перевірки.
Перші результати після зміни інтерфейсу не завжди відображають її довгостроковий ефект. Користувачі можуть тимчасово реагувати на новий елемент через незвичність або адаптацію до змін.
Тому для важливих змін варто оцінювати стабільність ефекту протягом тесту, а за потреби — аналізувати поведінку різних когорт і ключові метрики після завершення експерименту.
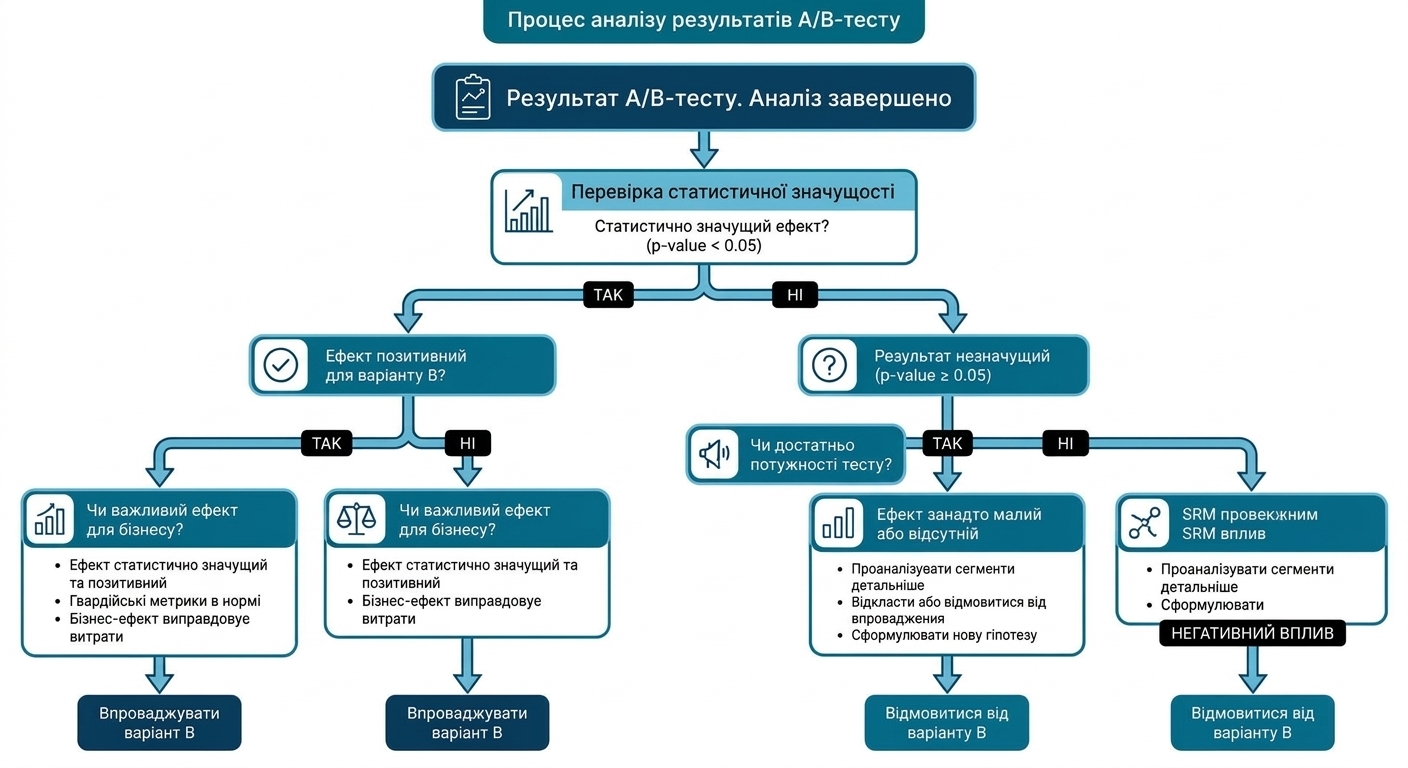
У підсумку результат A/B-тесту потрібно оцінювати не за одним p-value, а одночасно за розміром ефекту, його невизначеністю, бізнес-цінністю, якістю даних та стабільністю результату.
Після аналізу результатів потрібно визначити наступний крок. Він залежить не лише від того, який варіант показав кращу метрику, а й від статистичної невизначеності, якості даних та бізнес-ефекту.
Якщо для B виявлено статистично значущий ефект, перед впровадженням варто перевірити:
Наприклад, зростання конверсії на 5% може виглядати позитивно, але якщо одночасно зменшився середній чек, загальний бізнес-ефект може бути іншим.
Тому рішення про впровадження варто приймати на основі сукупності метрик, розміру ефекту, його невизначеності та бізнес-цінності, а не лише p-value.
p ≥ 0,05 не доводить, що A і B однакові. Це означає, що в межах проведеного експерименту не було достатніх статистичних підстав підтвердити різницю між варіантами.
Перед рішенням варто перевірити:
Якщо тест був недостатньо потужним, а потенційний ефект важливий для бізнесу, експеримент можна повторити з правильно розрахованою вибіркою. Якщо ж тест був спланований належним чином і практично важливого ефекту не виявлено, це може бути підставою відкласти зміну або переглянути гіпотезу.
Негативний результат — нормальна частина експериментування. Якщо технічних або методологічних проблем не виявлено, він означає, що конкретна зміна не дала очікуваного результату за умов цього експерименту.
Не варто намагатися «врятувати» таку гіпотезу пошуком випадкового позитивного сегмента. Натомість отримані дані можна використати для формування наступної гіпотези або відмовитися від зміни.
Головний принцип: результат A/B-тесту — це не просто відповідь «A чи B». Це підстава для наступного рішення: впровадити зміну, повторити тест, змінити гіпотезу або відмовитися від неї.
Перед тим як використовувати результат A/B-тесту для бізнес-рішення, перевірте основні умови експерименту.
Головне правило: не оцінюйте тест лише за тим, чи стало p-value < 0,05. Перед рішенням перевірте якість даних, статистичну невизначеність, розмір ефекту, бізнес-цінність та вплив на інші метрики.
A/B-тестування — це спосіб перевіряти гіпотези на даних, а не інструмент для підтвердження заздалегідь бажаного рішення. Навіть статистично значущий результат може виявитися недостатньо цінним для бізнесу, якщо ефект занадто малий, дані зібрані некоректно або зміна негативно впливає на інші важливі метрики.
Надійність експерименту формується на всіх етапах: від чіткої гіпотези, вибору метрик і розрахунку вибірки до правильного проведення тесту та обережної інтерпретації результатів. Важливо не зупиняти тест через тимчасовий позитивний результат, не шукати позитивний сегмент постфактум і не плутати відсутність статистичної значущості з доказом того, що варіанти однакові.
Головний принцип: хороший A/B-тест має заздалегідь визначені правила, а висновок формується за результатами експерименту, а не навпаки. Іноді результатом буде впровадження варіанта B, іноді — повторний тест, зміна гіпотези або відмова від неї. У кожному випадку цінність експерименту полягає в тому, що рішення приймається на основі даних, а не припущень.
A/B-тести — частина ширшої роботи з оптимізації конверсії (CRO), і їхні висновки надійні настільки, наскільки точна аналітика. Якщо потрібно налаштувати відстеження подій і конверсій, з якого почнеться будь-який експеримент, подивіться формат послуги налаштування веб-аналітики.