A/B-тестирование призвано заменить догадки подтверждёнными данными. Однако между статистически значимым результатом в отчёте и реальным бизнес-эффектом может быть существенная разница. Рост конверсии может оказаться случайным колебанием, следствием некорректного распределения трафика или эффектом, который сопровождается падением среднего чека.
Цена таких ошибок может быть высокой: команда тратит ресурсы на ненужные изменения, маркетинг получает ложные ориентиры, а бизнес — неожиданный финансовый результат. Проблема возникает тогда, когда A/B-тест воспринимают как простое сравнение двух показателей конверсии, игнорируя методологию эксперимента.
Надёжный эксперимент требует чёткой гипотезы, правильно рассчитанной выборки и заранее определённых правил проведения и интерпретации. В этой статье разберём главные статистические и организационные ловушки A/B-тестирования и выясним, как превратить результаты эксперимента в обоснованные бизнес-решения.
Надёжность A/B-теста во многом определяется ещё до его запуска. Если заранее не определить гипотезу, ключевые метрики и правила проведения эксперимента, полученные данные легко интерпретировать неправильно.
Подход «давайте что-нибудь изменим и посмотрим, что будет» создаёт риск получить результат, который сложно объяснить. До начала теста стоит сформулировать проверяемую гипотезу по простой схеме:
Если мы изменим X, это повлияет на Y, потому что Z.
Например: если сократить форму заказа с 6 полей до 3, конверсия вырастет, потому что пользователям будет проще её заполнить.
Также заранее следует определить, какой результат будет иметь практическую ценность для бизнеса и какой минимальный эффект имеет смысл выявлять.
Одной конверсии часто недостаточно для оценки эксперимента.
Например, новая страница может увеличить количество заказов, но одновременно уменьшить средний чек. Если смотреть только на конверсию, такой результат легко интерпретировать неправильно. Поэтому ключевые метрики лучше определить до запуска теста, а не выбирать после просмотра результатов.
Не стоит останавливать тест по принципу «собрали 100 конверсий — достаточно». Необходимый размер выборки зависит от текущей конверсии, ожидаемого эффекта, допустимого уровня статистической ошибки и желаемой статистической мощности.
Здесь важен показатель MDE (Minimum Detectable Effect) — минимальный эффект, который тест должен быть способен выявить. Его стоит связывать не только со статистикой, но и с бизнес-ценностью изменения: если очень небольшой рост метрики не имеет практического значения, нет смысла строить эксперимент вокруг такого эффекта.
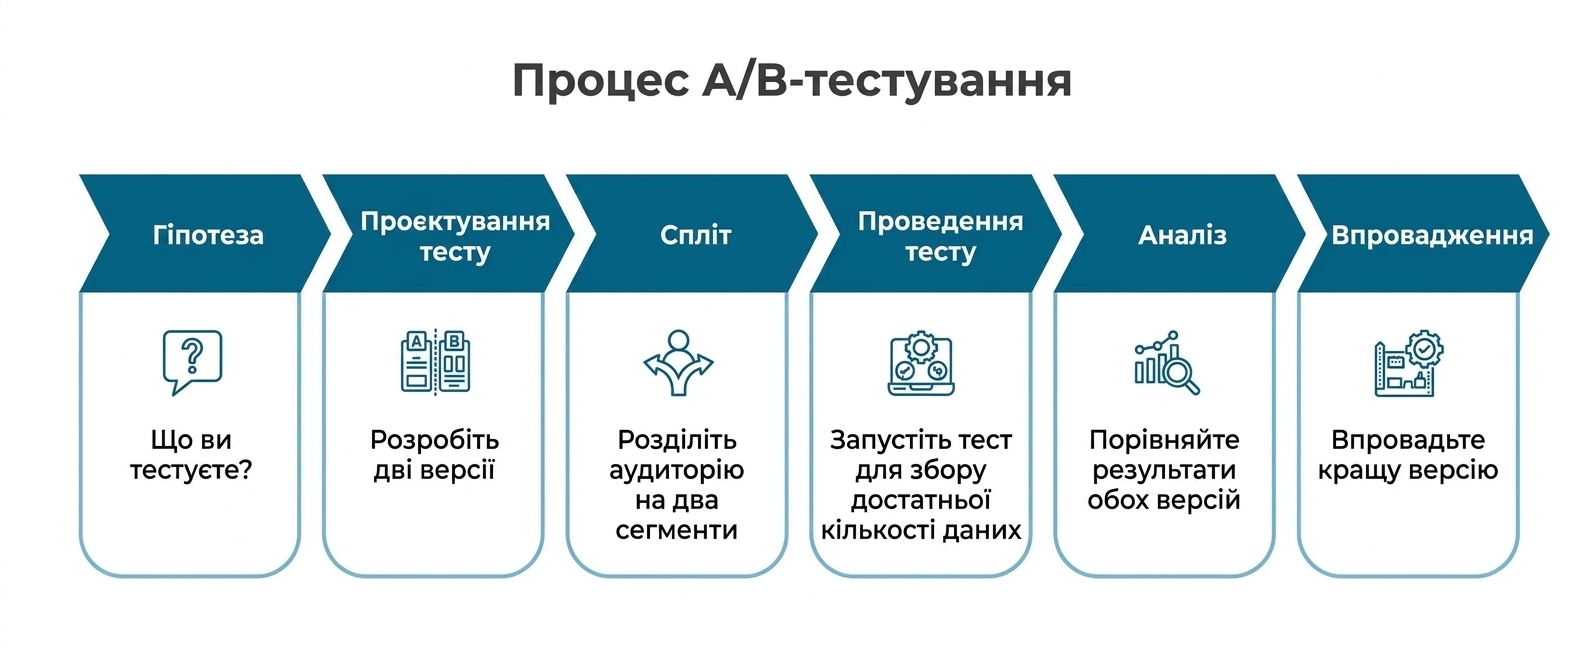
Итак, ещё до старта нужно определить гипотезу, основную метрику, минимальный практически важный эффект и необходимый объём данных. Это задаёт чёткие правила эксперимента и снижает риск подгонять их под полученный результат.
Даже хорошо спланированный A/B-тест можно испортить уже во время сбора данных. Самые частые проблемы — преждевременная остановка, внешние факторы, некорректное распределение пользователей и поиск положительного результата среди большого количества сравнений.
Если проверять результаты каждый день и остановить тест сразу после появления статистически значимой разницы, можно принять случайное колебание за реальный эффект. Чем больше раз проверять данные без учёта этого в статистическом плане, тем выше риск ложноположительного вывода.
Поэтому до запуска нужно определить размер выборки и критерии завершения теста. Не стоит останавливать эксперимент только потому, что сегодня p-value стало меньше 0,05.
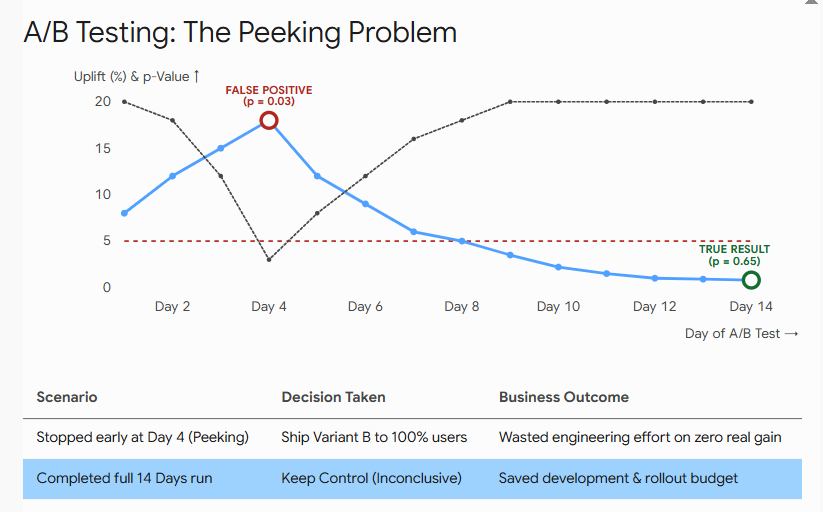
Сравнительный блок показывает бизнес-последствия обоих решений:
Результат в середине теста не обязательно является финальным.
Если бизнесу нужно регулярно принимать решения ещё до завершения запланированного теста, можно использовать специальные методы последовательного анализа (Sequential Testing), которые учитывают многократные проверки данных.
На результаты A/B-теста могут влиять не только различия между вариантами, но и события вокруг эксперимента: рекламные кампании, распродажи, праздники, технические сбои или изменения источников трафика.
Например, во время крупной акции на сайт может прийти нетипичная аудитория, а сбой платёжной системы — одновременно снизить конверсию в обеих группах.
Поэтому длительность теста нужно определять не по универсальному правилу «7 или 14 дней», а с учётом необходимого объёма выборки, сезонности и бизнес-циклов. Если поведение пользователей сильно отличается в течение недели, стоит охватить полные циклы, а не завершать тест посреди них.
Для корректного A/B-теста пользователи должны случайно распределяться между группами и, как правило, оставаться в одной группе на протяжении эксперимента.
Перед запуском более сложных тестов может быть полезен A/A-тест — когда обе группы получают одинаковый вариант. Он помогает проверить механику рандомизации, трекинг и возможные систематические проблемы.
Отдельно стоит следить за Sample Ratio Mismatch (SRM) — ситуацией, когда фактическое распределение пользователей существенно отличается от запланированного. Например, вместо ожидаемых 50/50 система стабильно распределяет трафик 52/48.
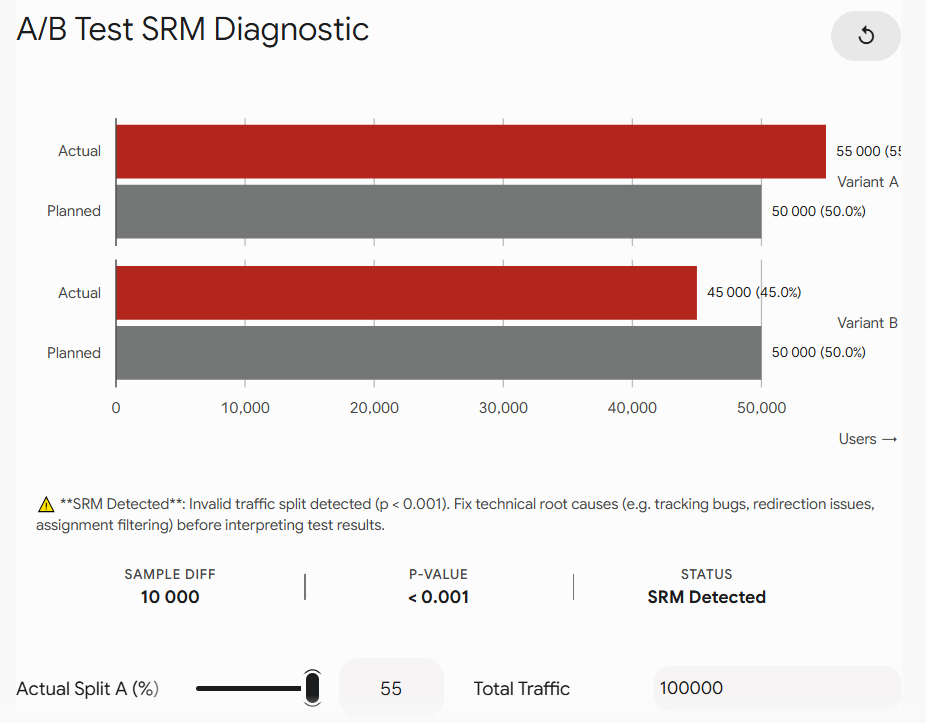
SRM может сигнализировать о технической проблеме, ошибке в логике эксперимента или особенностях сбора данных. Пока причина не выяснена, результаты такого теста нужно интерпретировать очень осторожно.
Ещё одна ловушка — одновременно тестировать много вариантов или после завершения эксперимента проверять десятки сегментов в поисках положительного результата.
Чем больше независимых сравнений мы делаем, тем выше вероятность случайно получить статистически значимый результат. Например, если проверять много сегментов, можно найти группу, где B показал положительный результат просто из-за статистического шума.
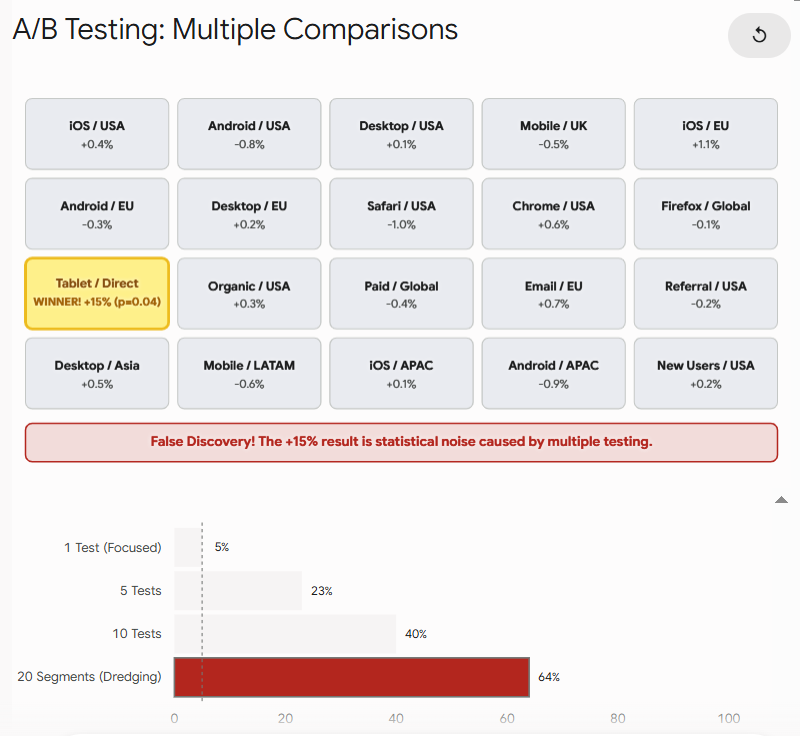
Поэтому важные сравнения и сегменты лучше определять до начала теста. Если же одновременно проверяется много гипотез, могут понадобиться методы коррекции множественных сравнений, в частности Bonferroni или контроль FDR.
Завершение теста и статистически значимый результат ещё не означают, что изменение нужно сразу внедрять. После завершения эксперимента важно оценить не только статистический результат, но и размер эффекта, его бизнес-ценность и условия, в которых он был получен.
p < 0,05 означает, что в рамках заданной статистической модели полученные данные были бы маловероятны при предположении об отсутствии эффекта. Но этот показатель сам по себе не показывает ни размер эффекта, ни его экономическую ценность.
На большой выборке статистически значимым может стать даже очень небольшой рост конверсии. Поэтому после теста стоит оценить:
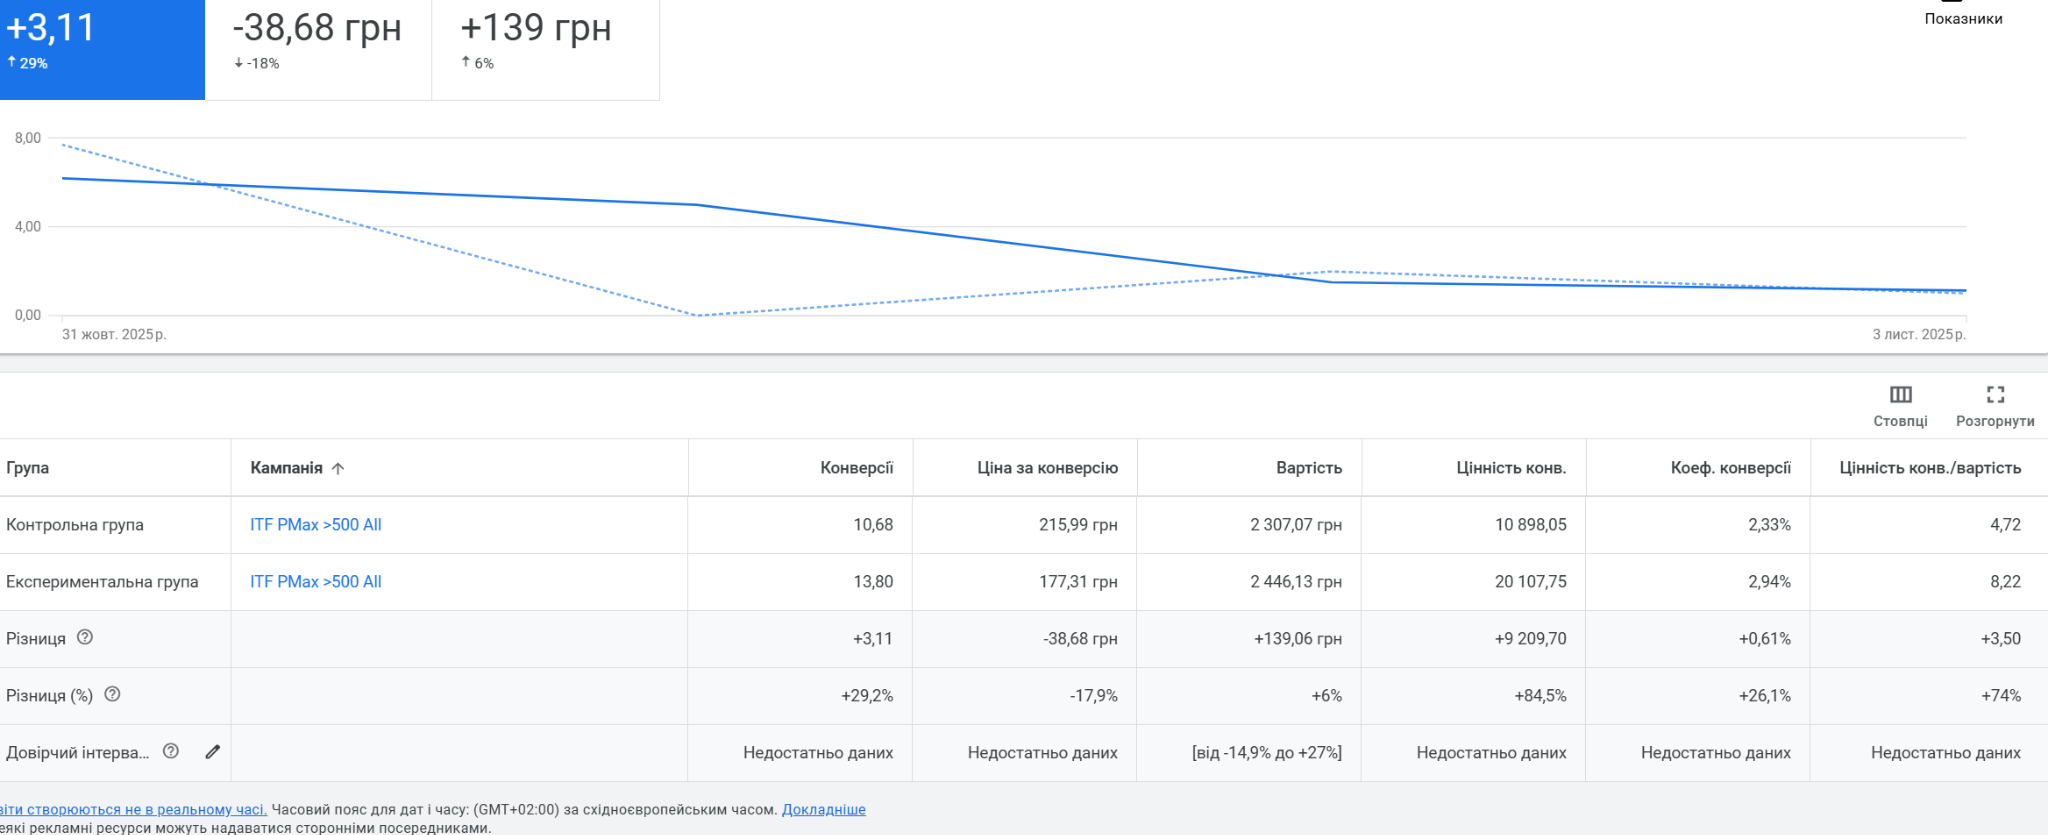
Скриншот из Google Ads Experiments: иллюзия быстрой победы. Несмотря на впечатляющий рост показателей (ROAS +74%), алгоритм предупреждает — «Недостаточно данных». Если остановить тест на этом этапе, выводы будут статистически недостоверными.
MDE определяют до запуска теста как минимальный эффект, имеющий практическое значение для бизнеса. Если статистически значимый результат оказался намного меньше этого ориентира, это повод оценить целесообразность изменения, а не просто объявлять B победителем.
A/B-тест с правильной рандомизацией даёт основания делать причинный вывод: в условиях проведённого эксперимента изменение X вызвало изменение Y.
Но такой результат не обязательно будет одинаковым для любой аудитории и в любой момент. Эффект может отличаться в зависимости от:
Поэтому вывод лучше формулировать конкретно: «В проведённом эксперименте изменение X увеличило Y», а не «это изменение всегда увеличивает Y».
После теста легко найти положительный результат в каком-нибудь сегменте, если проверить достаточно много вариантов: устройства, страны, источники трафика и т. д.
Если сегмент был определён до запуска теста и для него существовала отдельная гипотеза, его анализ имеет чёткое обоснование. Если же после общего результата проверить десятки сегментов и выбрать тот, где случайно получилось +15%, это может быть следствием множественного тестирования. Поэтому неожиданные находки в сегментах лучше рассматривать как новые гипотезы для проверки, а не как готовое доказательство для внедрения.
Также стоит проверять структуру трафика: если доли разных типов пользователей в группах A и B заметно отличаются, это может влиять на общий результат и требует отдельной проверки.
Первые результаты после изменения интерфейса не всегда отражают его долгосрочный эффект. Пользователи могут временно реагировать на новый элемент из-за непривычности или адаптации к изменениям.
Поэтому для важных изменений стоит оценивать стабильность эффекта на протяжении теста, а при необходимости — анализировать поведение разных когорт и ключевые метрики после завершения эксперимента.
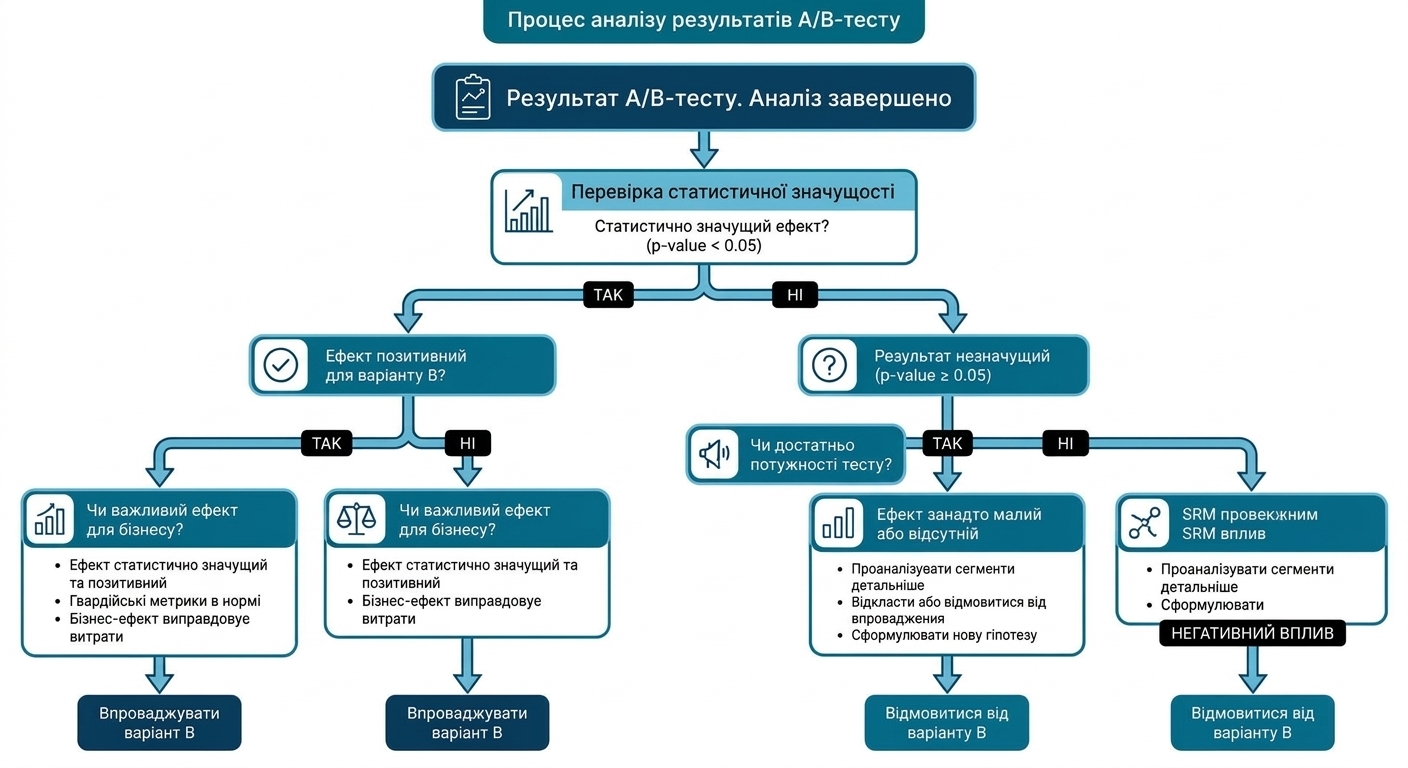
В итоге результат A/B-теста нужно оценивать не по одному p-value, а одновременно по размеру эффекта, его неопределённости, бизнес-ценности, качеству данных и стабильности результата.
После анализа результатов нужно определить следующий шаг. Он зависит не только от того, какой вариант показал лучшую метрику, но и от статистической неопределённости, качества данных и бизнес-эффекта.
Если для B выявлен статистически значимый эффект, перед внедрением стоит проверить:
Например, рост конверсии на 5% может выглядеть позитивно, но если одновременно уменьшился средний чек, общий бизнес-эффект может быть другим.
Поэтому решение о внедрении стоит принимать на основе совокупности метрик, размера эффекта, его неопределённости и бизнес-ценности, а не только p-value.
p ≥ 0,05 не доказывает, что A и B одинаковы. Это означает, что в рамках проведённого эксперимента не было достаточных статистических оснований подтвердить разницу между вариантами.
Перед решением стоит проверить:
Если тест был недостаточно мощным, а потенциальный эффект важен для бизнеса, эксперимент можно повторить с правильно рассчитанной выборкой. Если же тест был спланирован должным образом и практически важного эффекта не выявлено, это может быть основанием отложить изменение или пересмотреть гипотезу.
Отрицательный результат — нормальная часть экспериментирования. Если технических или методологических проблем не выявлено, он означает, что конкретное изменение не дало ожидаемого результата в условиях этого эксперимента.
Не стоит пытаться «спасти» такую гипотезу поиском случайного положительного сегмента. Вместо этого полученные данные можно использовать для формулировки следующей гипотезы или отказаться от изменения.
Главный принцип: результат A/B-теста — это не просто ответ «A или B». Это основание для следующего решения: внедрить изменение, повторить тест, изменить гипотезу или отказаться от неё.
Прежде чем использовать результат A/B-теста для бизнес-решения, проверьте основные условия эксперимента.
Главное правило: не оценивайте тест только по тому, стало ли p-value < 0,05. Перед решением проверьте качество данных, статистическую неопределённость, размер эффекта, бизнес-ценность и влияние на другие метрики.
A/B-тестирование — это способ проверять гипотезы на данных, а не инструмент для подтверждения заранее желаемого решения. Даже статистически значимый результат может оказаться недостаточно ценным для бизнеса, если эффект слишком мал, данные собраны некорректно или изменение негативно влияет на другие важные метрики.
Надёжность эксперимента формируется на всех этапах: от чёткой гипотезы, выбора метрик и расчёта выборки до правильного проведения теста и осторожной интерпретации результатов. Важно не останавливать тест из-за временного положительного результата, не искать положительный сегмент постфактум и не путать отсутствие статистической значимости с доказательством того, что варианты одинаковы.
Главный принцип: хороший A/B-тест имеет заранее определённые правила, а вывод формируется по результатам эксперимента, а не наоборот. Иногда результатом будет внедрение варианта B, иногда — повторный тест, изменение гипотезы или отказ от неё. В каждом случае ценность эксперимента в том, что решение принимается на основе данных, а не предположений.
A/B-тесты — часть более широкой работы по оптимизации конверсии (CRO), и их выводы надёжны настолько, насколько точна аналитика. Если нужно настроить отслеживание событий и конверсий, с которого начинается любой эксперимент, посмотрите формат услуги настройки веб-аналитики.