AI-системы уже постоянно читают сайты: чтобы отвечать пользователям и выполнять задачи как AI-агенты. Для их удобства предложили файл llms.txt — короткую карту ключевого контента сайта. Вокруг него возникло немало мифов: его называют новым SEO-фактором или обязательным условием для появления в ChatGPT или Google AI Overviews.
В этой статье разберём:
llms.txt — это предложенная спецификация Markdown-файла, который размещают на сайте. Он содержит краткое описание проекта, важный контекст и ссылки на ключевые материалы.
Предложение создал Jeremy Howard в сентябре 2024 года. Текущая версия спецификации — v2, обновлённая 10 августа 2026 года. Важно: это именно предложение по стандартизации, а не обязательный веб-стандарт.
Если упростить, llms.txt — это короткий навигатор для AI-агента:
вот что это за сайт, какие материалы на нём самые важные и где найти подробную информацию.
Файл не обязан содержать всю информацию сайта. Наоборот, его задача — дать сжатый контекст и ссылки на материалы, которые агент загрузит при необходимости.
Обычные HTML-страницы созданы для людей и перегружены навигацией, кодом и рекламой. llms.txt даёт AI-агенту компактную точку входа: краткое описание сайта и структурированный список важных ресурсов. Детали агент загружает по ссылкам только тогда, когда это действительно нужно.
Однако это не гарантия: наличие файла не означает, что каждый AI-сервис его прочитает или использует.
Обязателен только один элемент — заголовок H1 с названием сайта или проекта. Остальные элементы рекомендованы и идут в таком порядке:
- [Название](URL): краткое описание ресурса.Самый распространённый вариант — в корне домена:
https://example.com/llms.txt
Но спецификация v2 позволяет размещать файл и в отдельном подразделе сайта:
https://example.com/docs/llms.txt
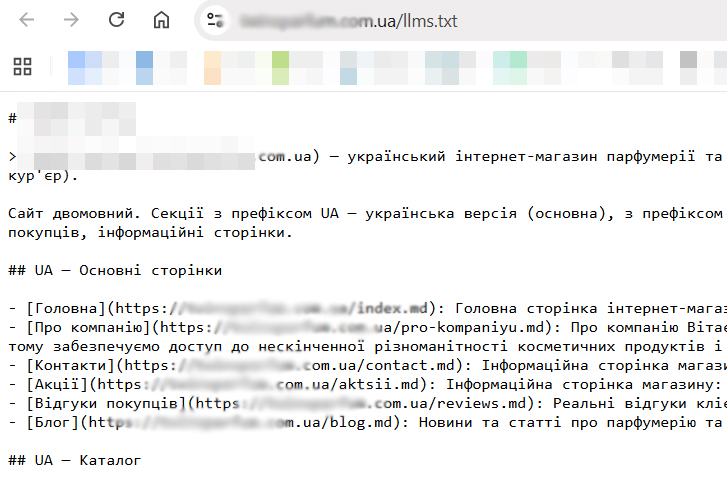
В таком случае файл описывает URL в пределах своего пути. Если к одному URL подходит несколько файлов, агент должен использовать самый специфичный. Это особенно удобно для больших сайтов с независимыми разделами: документацией, базой знаний, отдельным продуктом.
llms.txt задуман прежде всего для сценариев inference — когда AI-агенту во время выполнения запроса нужно сориентироваться на сайте и найти релевантные материалы. Он служит навигатором, а не заменой robots.txt для управления доступом краулеров.
Формат остаётся предложенной инициативой, а не обязательным стандартом. Ни один из крупных AI-сервисов не подтвердил, что читает llms.txt при ответах пользователям.
Исследование Ahrefs (июнь 2026 года) охватило 137 210 доменов: llms.txt был у 28% из них. Среди примерно 38 тыс. сайтов с файлом 97% не получили ни одного запроса к нему за май 2026 года. 96% запросов, которые всё же поступали, делали боты. При этом 77% этих ботов вообще не принадлежали AI-сервисам — это SEO-аудиторы, сканеры технологий и другие краулеры. На AI retrieval bots, которые ищут материалы для ответов в AI-поиске (OAI-SearchBot, PerplexityBot), пришлось лишь 1,1% запросов от ботов.
Исследование не доказывает, что файл никогда не используется, но показывает: пока его читают далеко не все.
Итак, llms.txt — опциональный навигационный формат для совместимых агентов, а не гарантированный канал связи со всеми AI-системами.
Эти три файла решают разные задачи.
| Файл | Основная задача |
| robots.txt | Указывает автоматизированным системам правила доступа к частям сайта |
| sitemap.xml | Помогает поисковым системам находить URL сайта |
| llms.txt | Даёт AI-агентам сжатый контекст и подборку важных материалов |
Заменяет ли llms.txt другие технические файлы? Нет. llms.txt не устанавливает правил доступа и не заменяет другие файлы:
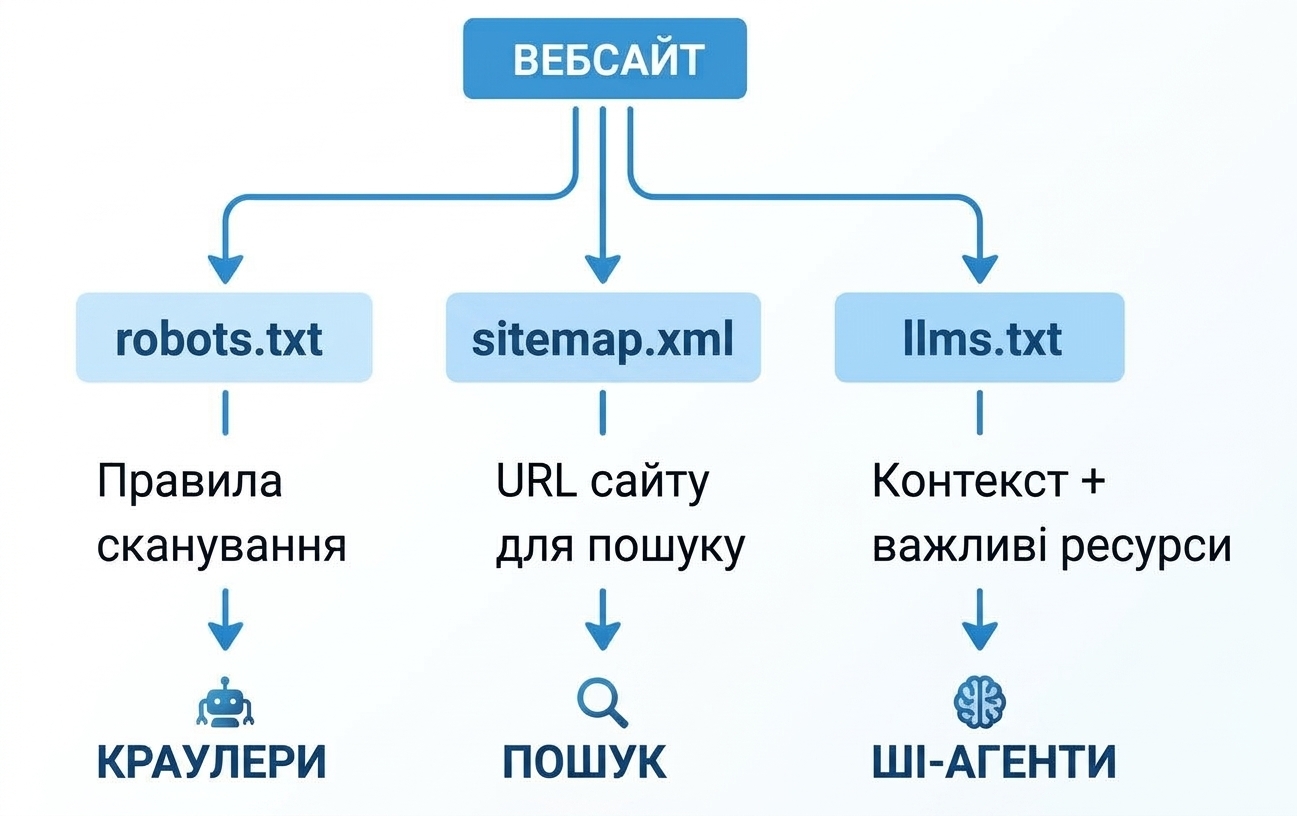
Обычно все три файла лежат в корне сайта: /robots.txt, /sitemap.xml, /llms.txt. Но это не обязательно: карта сайта может иметь другой адрес (его указывают в robots.txt), а llms.txt — лежать в подразделе.
llms.txt не является фактором ранжирования. Google прямо указывает, что такие файлы не нужны для появления в Google Search, в том числе в его генеративных функциях: Google Search их игнорирует. Поэтому llms.txt не улучшает и не ухудшает видимость или позиции сайта в Google.
Само по себе создание файла:
Файл полезнее всего для проектов с большим объёмом структурированной и технической информации:
Для небольшого сайта из нескольких страниц практическая польза от отдельного навигационного файла невелика. Создавать llms.txt только ради SEO не имеет смысла, потому что Google не воспринимает его как сигнал для ранжирования.
Создание файла не требует сложной разметки. Главное — выбрать действительно важные материалы и подать их компактно.
В файл можно включить:
Не нужно добавлять каждый URL сайта.
Базовый файл может выглядеть так:
# Название сайта
> Краткое описание компании, продукта или проекта и контекст, необходимый для понимания приведённых материалов.
## Документация
- [Начало работы](https://example.com/docs/start): инструкция для новых пользователей.
- [API Reference](https://example.com/docs/api): полное описание API и параметров.
## Продукты
- [Продукт 1](https://example.com/product-1): описание возможностей и сценариев использования.
- [Продукт 2](https://example.com/product-2): функции, ограничения и условия использования.
## Гайды
- [Руководство по настройке](https://example.com/guide): пошаговая инструкция.
По спецификации обязателен только H1. Blockquote и секции со ссылками — рекомендованные элементы структуры.
Лучше не оставлять список URL без контекста. Сравните:
- [Документация](https://example.com/docs)
и:
- [Документация](https://example.com/docs): полное описание настройки, API и основных сценариев использования.
Второй вариант даёт агенту больше информации о том, что именно он найдёт по ссылке.
Файл должен быть компактным указателем, а не большой статьёй. Подробные пояснения, характеристики продуктов, инструкции и другие материалы лучше оставлять на отдельных страницах, на которые ссылается llms.txt.
Спецификация v2 предлагает не ограничиваться самим llms.txt, а давать AI-агентам чистые Markdown-версии страниц — по тому же адресу с расширением .md. Например, для страницы:
https://example.com/docs/api.html
Markdown-версия может находиться по адресу:
https://example.com/docs/api.html.md или https://example.com/docs/api.md
Чтобы агенты находили такие версии, спецификация рекомендует стандартные связи:
<link rel="alternate" type="text/markdown" href="/docs/api.md">
<link rel="describedby" href="/docs/llms.txt">
Первая указывает на Markdown-версию страницы, вторая — на llms.txt, который её описывает. Эти связи можно передавать как HTML-теги <link> или как HTTP-заголовок Link — это удобно, если не хочется менять шаблоны страниц.
Для всего сайта:
https://example.com/llms.txt
Для отдельного раздела:
https://example.com/docs/llms.txt
После публикации проверьте, что файл открывается без авторизации, возвращает код ответа 200, а все ссылки внутри него работают.
Если меняются продукты, документация, URL или структура сайта, эти изменения нужно внести и в llms.txt. Устаревший список ссылок менее полезен, чем актуальный компактный указатель.
В WordPress llms.txt можно создать вручную и загрузить в корень сайта или сгенерировать плагином: генератор файла есть, например, в Yoast SEO и AIOSEO. Wix создаёт llms.txt автоматически для каждого сайта, а платформы документации — для опубликованной документации.
После автоматического создания обязательно проверьте результат. Генераторы часто добавляют в файл все страницы, записи и категории подряд — а это именно та ошибка, от которой предостерегает спецификация. Уберите служебные и второстепенные URL и оставьте ключевые. Для небольших сайтов ручного создания файла обычно достаточно.
Для условного SaaS-сервиса файл может выглядеть так:
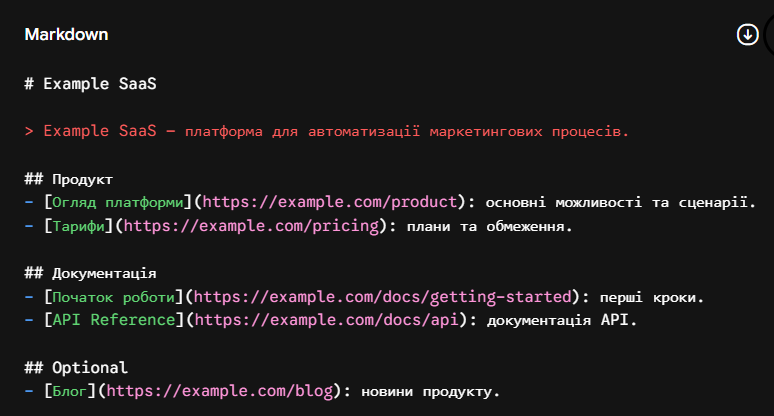
Секция Optional здесь содержит второстепенный контент. Это конвенция спецификации, а не команда, которая заставляет AI-систему определённым образом обрабатывать файл.
llms-full.txt часто упоминают вместе с llms.txt, но это разные вещи.
Спецификация llms.txt не описывает llms-full.txt. Этот формат используют отдельные платформы документации: они собирают в такой файл полный текст документации одним документом.
Поэтому наличие llms-full.txt на конкретном сайте — решение этой платформы, а не требование для всех сайтов.
llms.txt не должен превращаться во вторую sitemap.xml. Лучше выбрать материалы, которые действительно помогают понять продукт, услуги или тематику сайта.
Цель файла — не перечислить все страницы, а дать структурированный и отобранный контекст.
llms.txt не управляет доступом краулеров. Для правил сканирования используют robots.txt.
Если URL изменился, его нужно обновить и в llms.txt. Периодическая проверка ссылок — часть нормального обслуживания файла.
Наличие llms.txt не гарантирует, что AI-система процитирует сайт, упомянет бренд или приведёт дополнительный трафик. Для Google Search это подтверждено прямо: Google Search игнорирует llms.txt.
GEO (Generative Engine Optimization) — подходы к оптимизации видимости контента в генеративных поисковых и AI-системах. Чем GEO отличается от классического SEO, мы разбирали отдельно. llms.txt можно рассматривать как один из дополнительных технических элементов такой работы, но он не заменяет фундаментальное SEO, качественный контент и техническую доступность сайта. Google для генеративных функций Search советует и дальше применять базовые SEO-практики, а не искать отдельные «AI-хаки».
| llms.txt делает | llms.txt не делает |
| Даёт краткий контекст | Не управляет сканированием |
| Ссылается на важные материалы | Не заменяет sitemap.xml |
| Помогает структурировать контент для совместимых агентов | Не является фактором ранжирования в Google |
| Может упростить навигацию AI-агента | Не гарантирует цитирования |
| Может содержать ссылки на Markdown-версии | Не гарантирует появления в ChatGPT |
Файл можно сравнить с оглавлением книги: он помогает понять структуру, но не заменяет сам материал. Если на сайте нет качественной документации, полезных страниц или актуальной информации, список ссылок сам по себе не сделает контент ценнее для пользователей или AI-систем.
Для сайта, который хочет быть заметным в поиске и AI-сервисах, базовыми остаются:
llms.txt может дополнять эту систему, но сам по себе не определяет, процитирует ли страницу или упомянет ли бренд конкретная AI-система. Что реально влияет на появление в ответах ChatGPT, Perplexity и других AI-систем, мы рассказывали в отдельной статье.
llms.txt — опциональная спецификация для быстрой навигации AI-агентов по важному контенту сайта. Полезнее всего она для проектов с большим объёмом технической документации, баз знаний и SaaS-решений.
При этом файл не является обязательным элементом SEO и не гарантирует появления бренда в ответах ChatGPT, Perplexity или Google AI Overviews. Google прямо указывает, что llms.txt не влияет на ранжирование или видимость в поиске.
Если создание и поддержка файла не требуют значительных ресурсов, его можно добавить как элемент AI-friendly архитектуры. Но основной фокус стоит держать на качественном контенте, фундаментальном SEO и технической доступности сайта — именно с этим мы работаем в рамках услуги GEO-продвижения.